拥抱先进 AI,守护你的核心数据
企业受算力成本约束,难以私有化部署大模型,直接调用外部 AI 存在合同、客资、财务等敏感信息泄露风险,且传统脱敏处理后数据无法复用。我们推出青椒脱敏工作台,以低资源开销实现可逆脱敏:敏感字段替换为可追踪占位符,脱敏数据可对接任意 Agent 与模型平台,适配合同审核、材料润色、表格分析、文档问答等场景,助力企业安全调用外部 AI。
本地部署大模型
企业投入 GPU 算力与运维团队自研部署模型,常面临模型能力上限不足的问题,难以匹配复杂业务场景的诉求。
使用云端 AI
无需自建部署,注册即用,但涉密数据会直接传入 API 链路,存在数据留存、纳入模型训练的风险,且数据流向无法管控。
青椒脱敏工作台 + 云端 AI
以更小的资源完成敏感信息处理,轻松使用外部 AI 无需担心隐私泄露,结果 100% 还原。
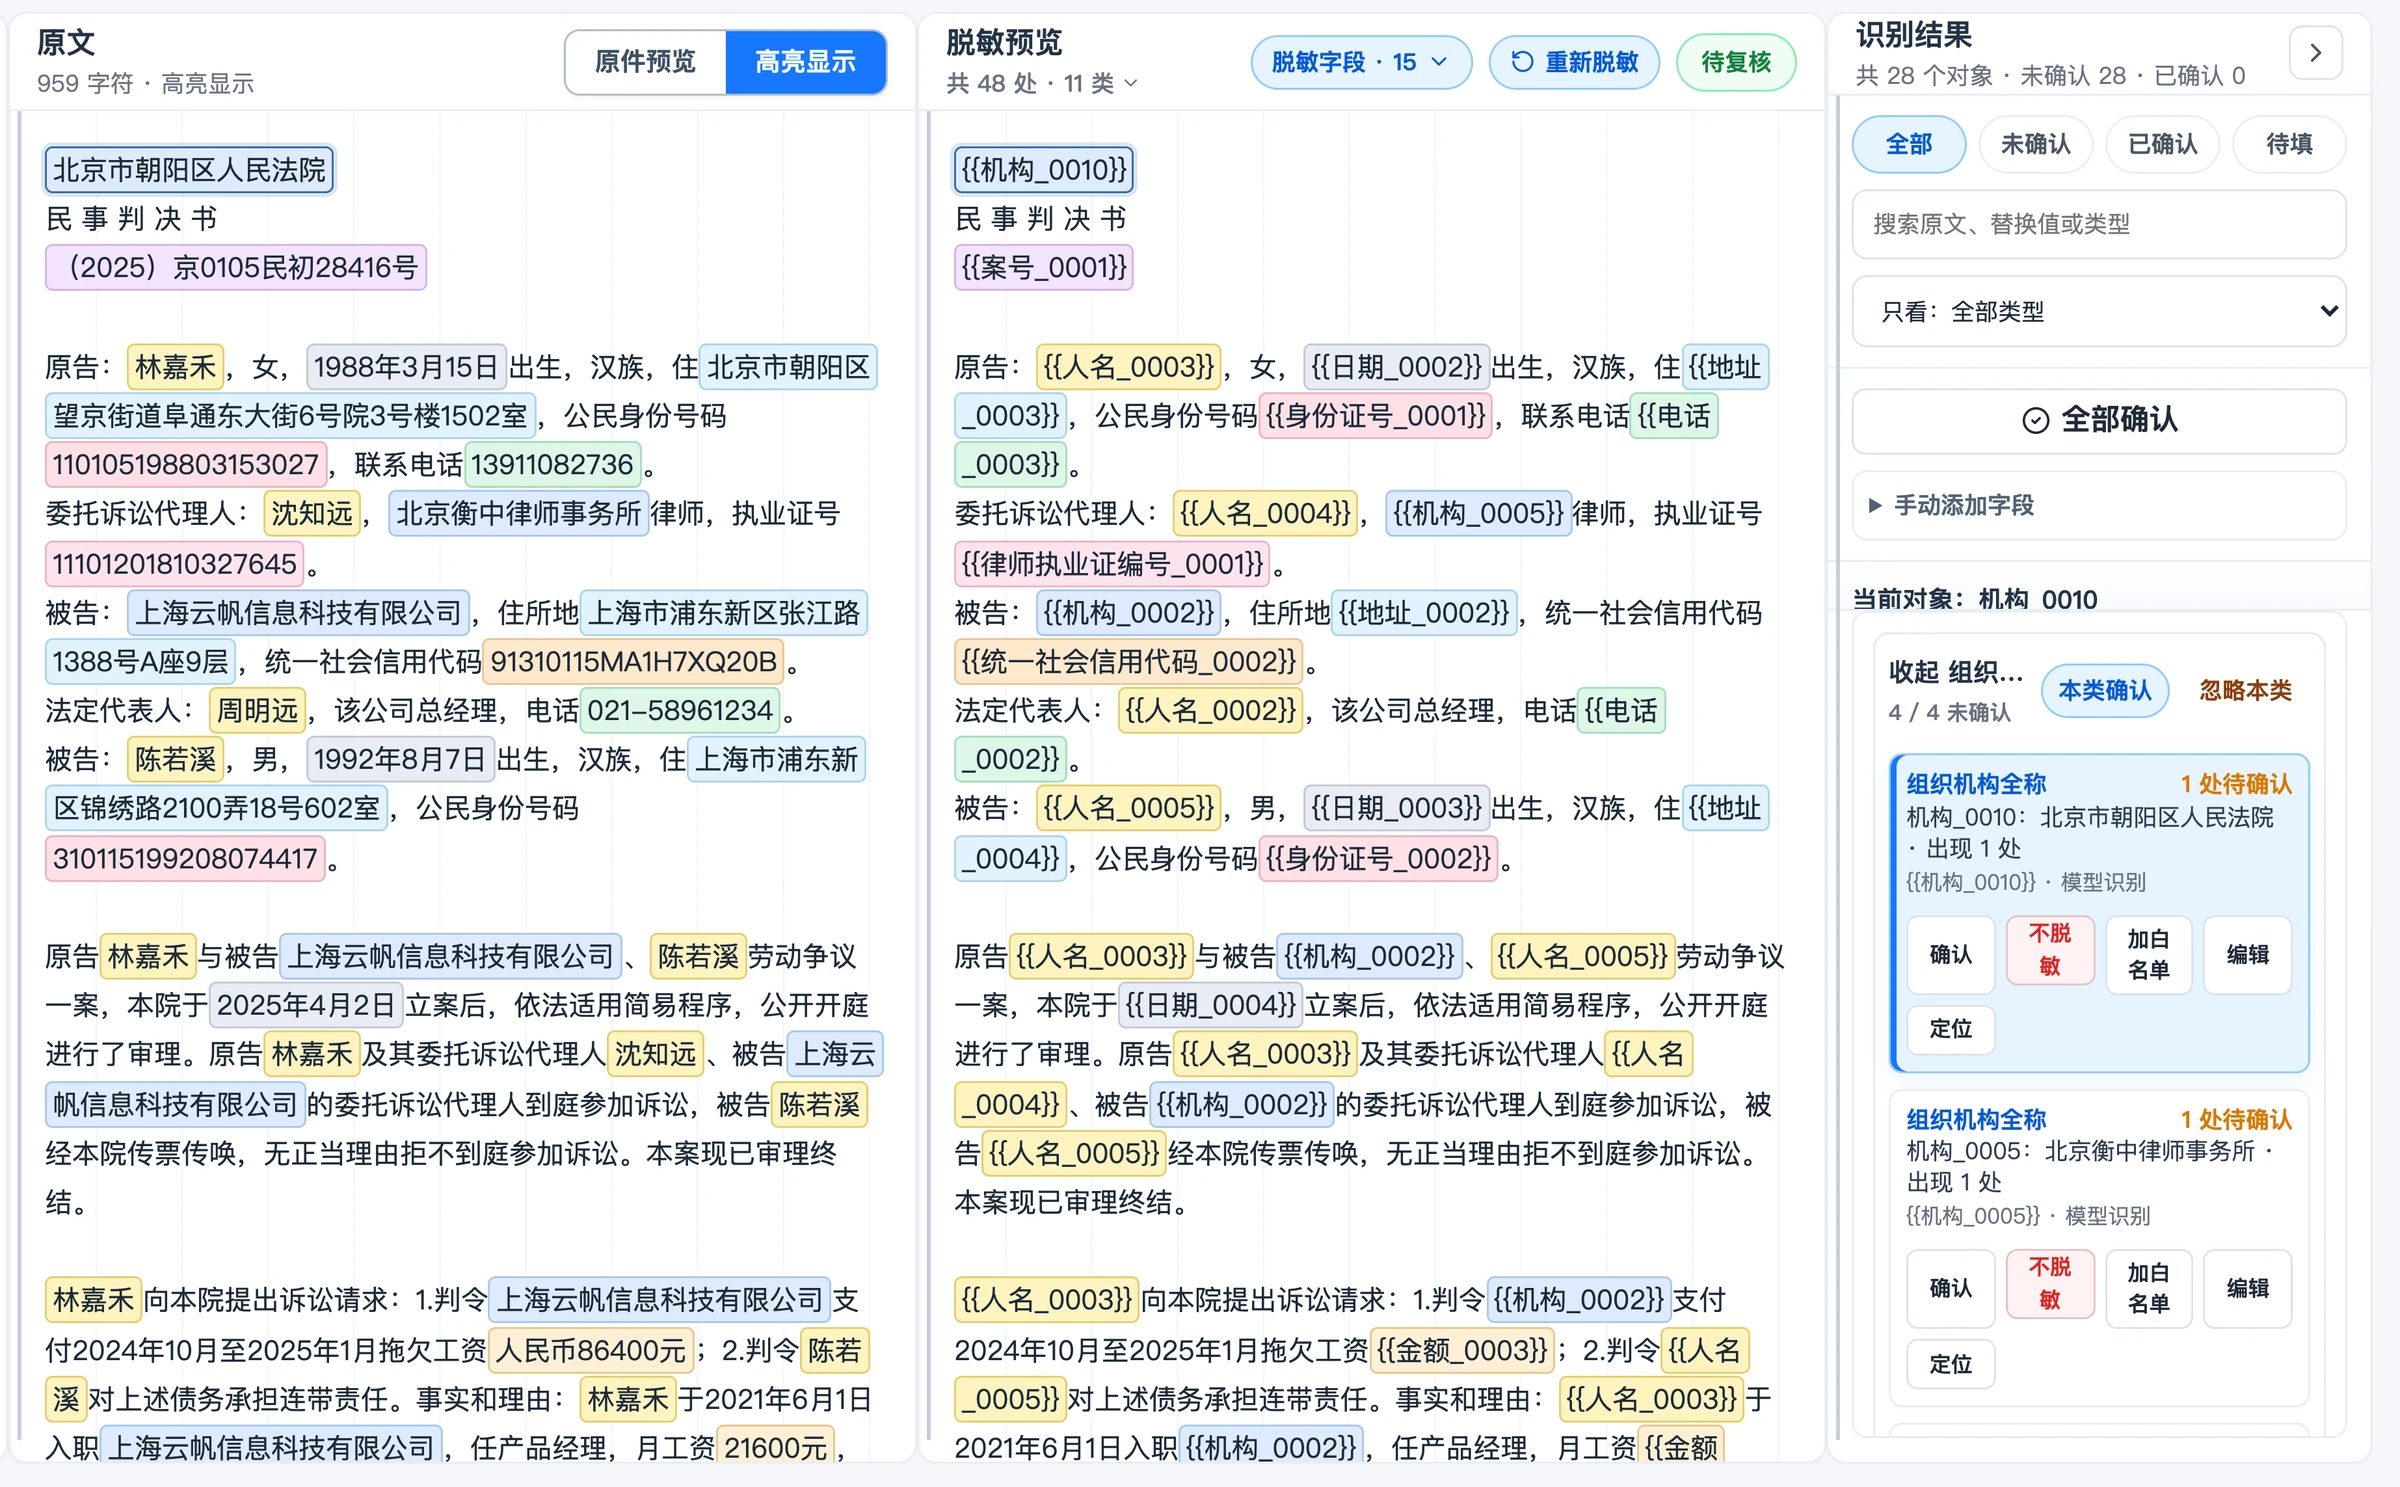
- 原文敏感信息按类别高亮展示
- 脱敏预览实时呈现脱敏后效果
- 识别结果支持逐项核验、剔除误判与编辑修改
先完成敏感信息预处理,再将文档交给 AI
构建「脱敏 - AI 处理 - 还原」完整闭环,右侧可演示真实交互全流程。
- 1
文件导入
支持合同、裁判文书、表格、演示文稿、扫描件与图片,统一在工作台内处理。
- 2
本地识别与人工复核
自动识别 26 类敏感信息并标注,支持逐项核验、剔除误判、补充漏识内容。
- 3
占位符映射替换
同一原文固定映射至唯一占位符,保证 AI 能够理解文档业务逻辑与关联关系。
- 4
交付 AI 处理
可导出脱敏文档,或直接调用内置问答,向外输出内容仅含占位标识。
- 5
一键还原原文
将 AI 返回结果回传工作台,依托映射表自动复原全部真实敏感信息。
第 1 步:原始材料
针对 周子健 于 2026年5月2日 提交的投诉,人力资源部约谈了其直属上级林佩瑶(工号 E-40417),地点为北风食品有限公司 苏州办公室。佩瑶否认了相关指控。周子健的联系邮箱为 [email protected]。
第 2 步:AI 所见内容
针对 {{人名_0001}} 于 {{日期_0001}} 提交的投诉,人力资源部约谈了其直属上级{{人名_0002}}(工号 {{工号_0001}}),地点为 {{机构_0001}}{{地址_0001}}办公室。{{人名_0003}}否认了相关指控。{{人名_0001}}的联系邮箱为 {{邮箱_0001}}。
第 3 步:AI 返回应答
- {{人名_0001}} 于 {{日期_0001}} 提交了投诉。
- 人力资源部在 {{地址_0001}} 办公室约谈了直属上级 {{人名_0002}}({{工号_0001}})。
- {{人名_0003}} 否认了指控,后续调查待定。
第 4 步:脱敏还原
- 周子健 于 2026年5月2日 提交了投诉。
- 人力资源部在 苏州 办公室约谈了直属上级 林佩瑶(E-40417)。
- 佩瑶 否认了指控,后续调查待定。
26 类敏感信息,自动识别,逐项复核
依托带格式校验的规则引擎识别各类编号,结合实体识别模型提取人名、机构、地址信息;所有识别结果进入复核清单,核验通过后方可导出。
证件编号
- 电话
- 邮箱
- 身份证号
- 银行账号
- 统一社会信用代码
- 律师执业证编号
- 政策文件编号
- 案号
- 金额
- 其他编号
实体信息
- 人名
- 组织机构全称
- 组织机构简称
- 项目名称
- 称谓
- 职位
- 文件名称
- 法律法规
地理时间
- 地址
- 日期
- 时间
- 邮编
网络车辆标识
- IP 地址
- MAC 地址
- 网址
- 车牌
图像敏感区
- 红色印章 · 自动识别
- 签名、照片 · 手动框选
支持自定义识别字段,例如员工工号、内部项目编号,同时可将产品名称、法院名称等配置为免脱敏白名单。
适配多种文件类型
Word
Excel
PowerPoint
PDF 与扫描件
图片
文本
眼见为实:脱敏效果与产品预览
原告林嘉禾起诉云帆公司,
请求支付工资86400元。
原告{{人名_0001}}起诉
{{机构_0001}},请求支付工资
{{金额_0001}}。
原告***起诉****,
请求支付工资******。
原告起诉,
请求支付工资。
- 01
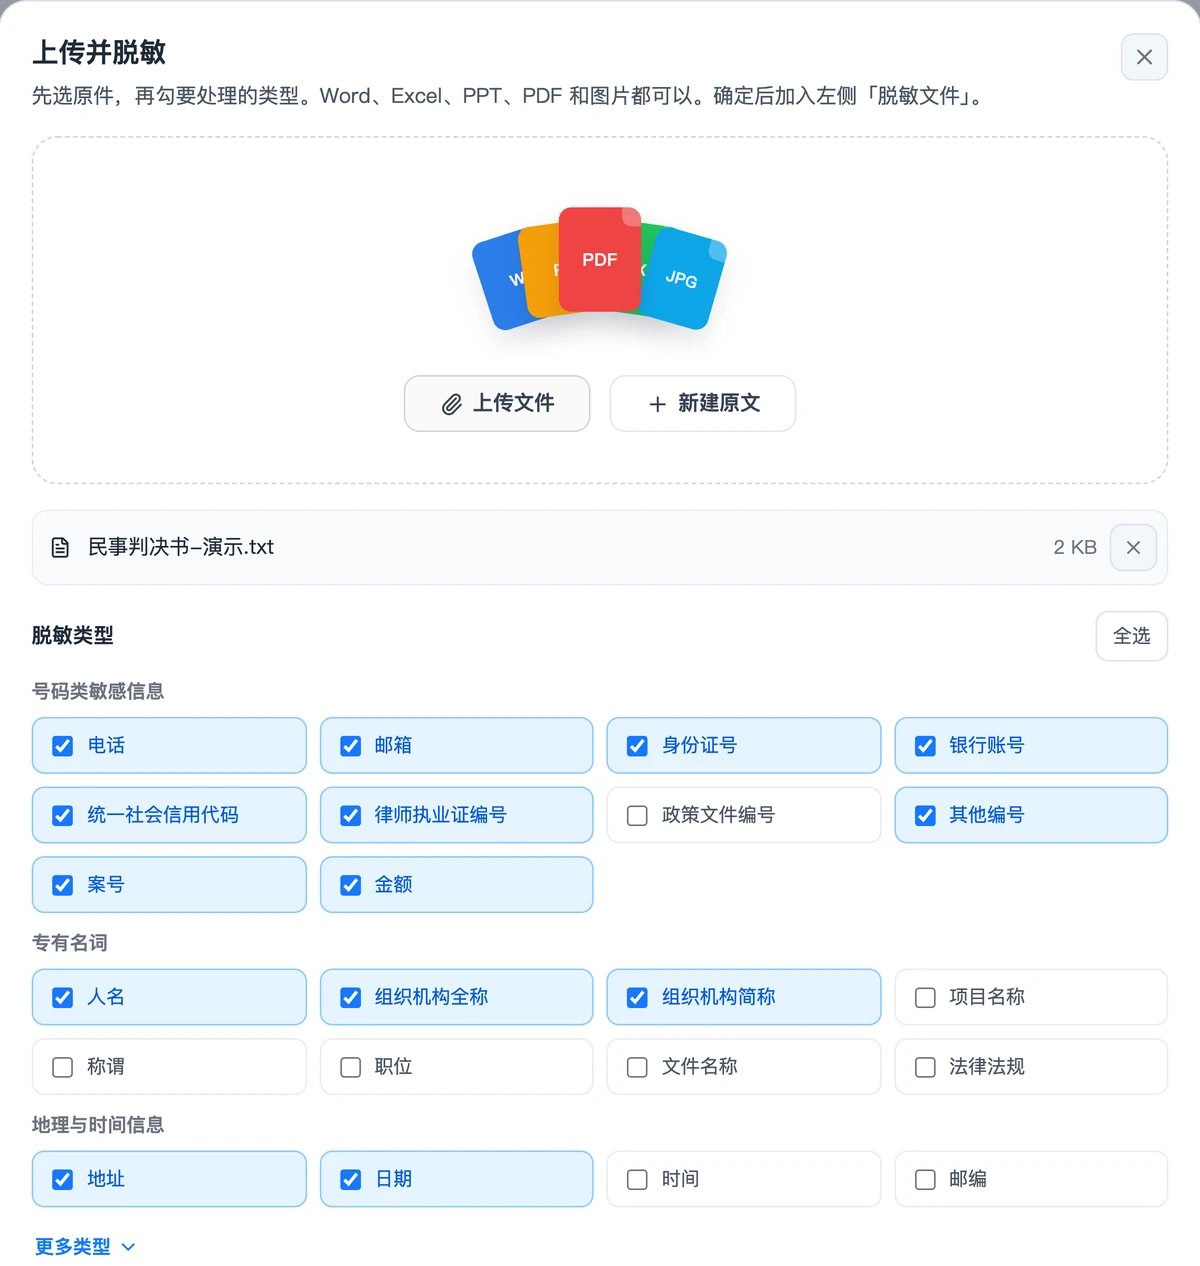
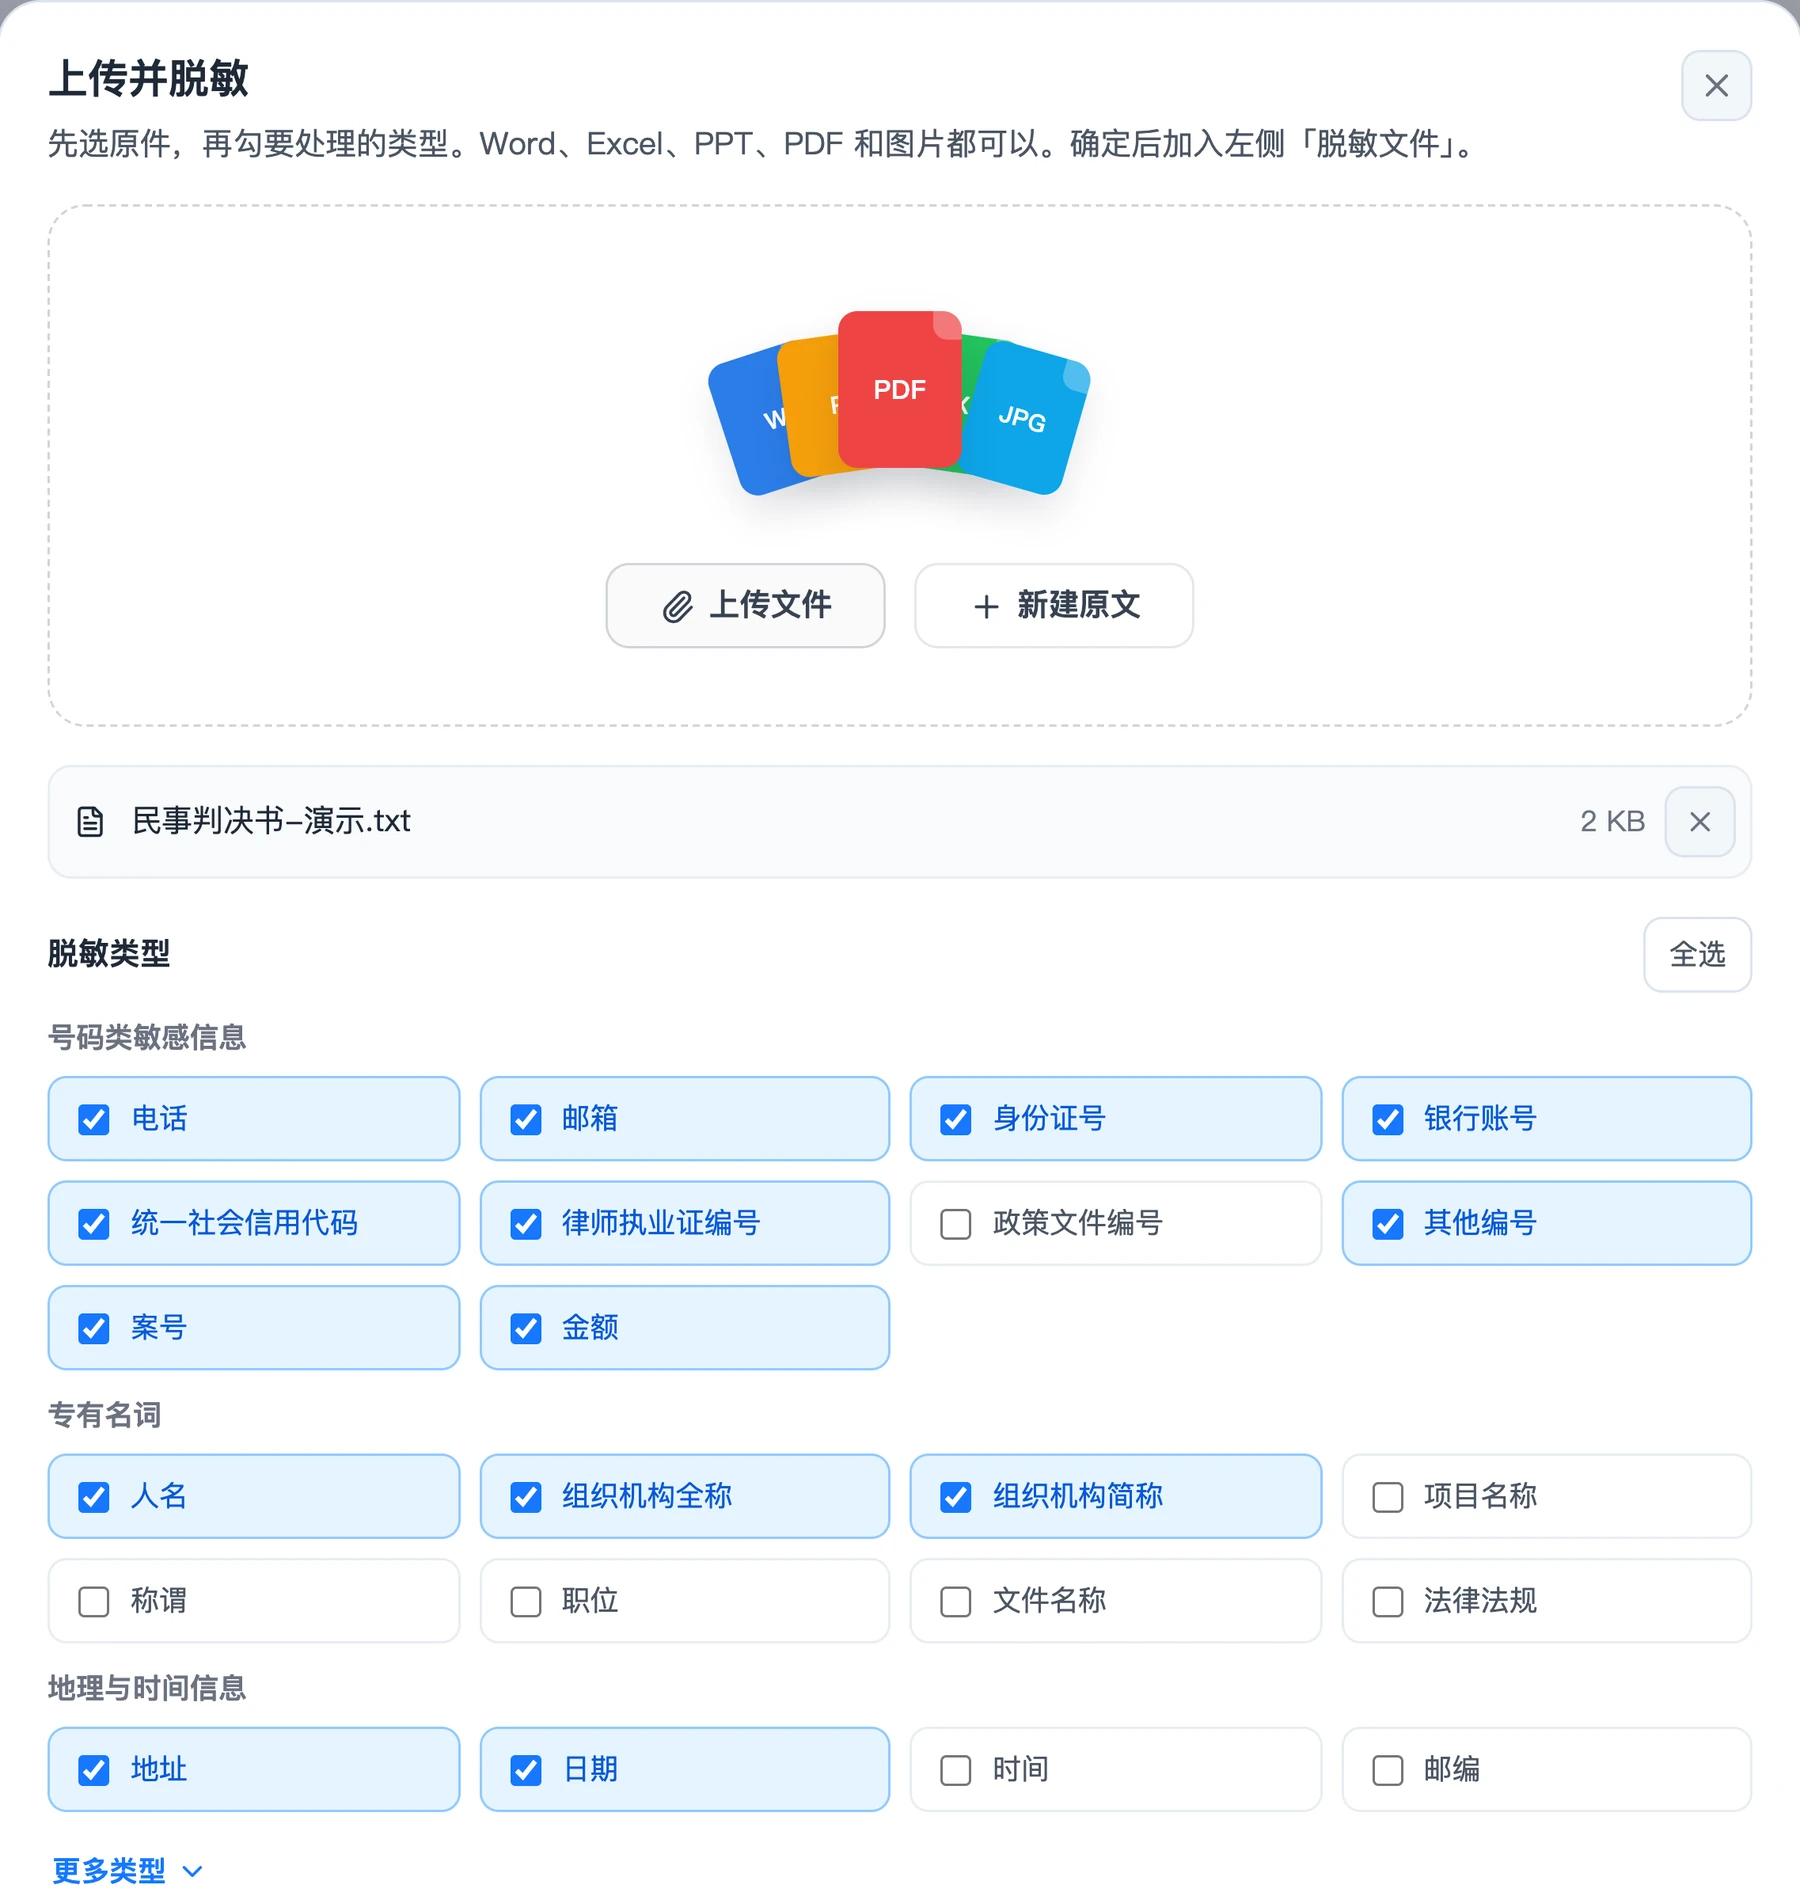
上传文件,选定脱敏类型
拖拽上传文档,按需勾选电话、证件号、银行账号、人名、机构、地址等敏感类别,确认后启动自动识别。
- 02
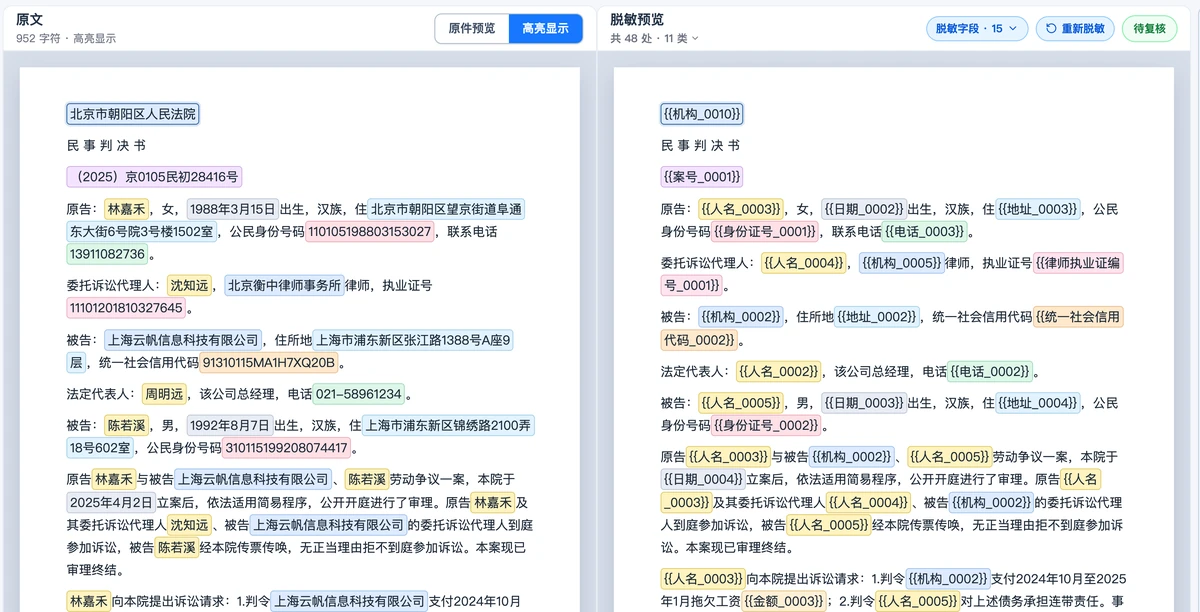
生成占位符,文档版式保持原样
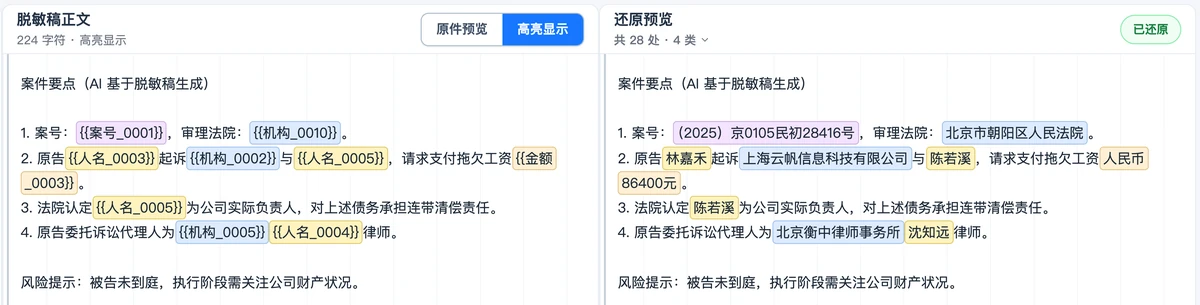
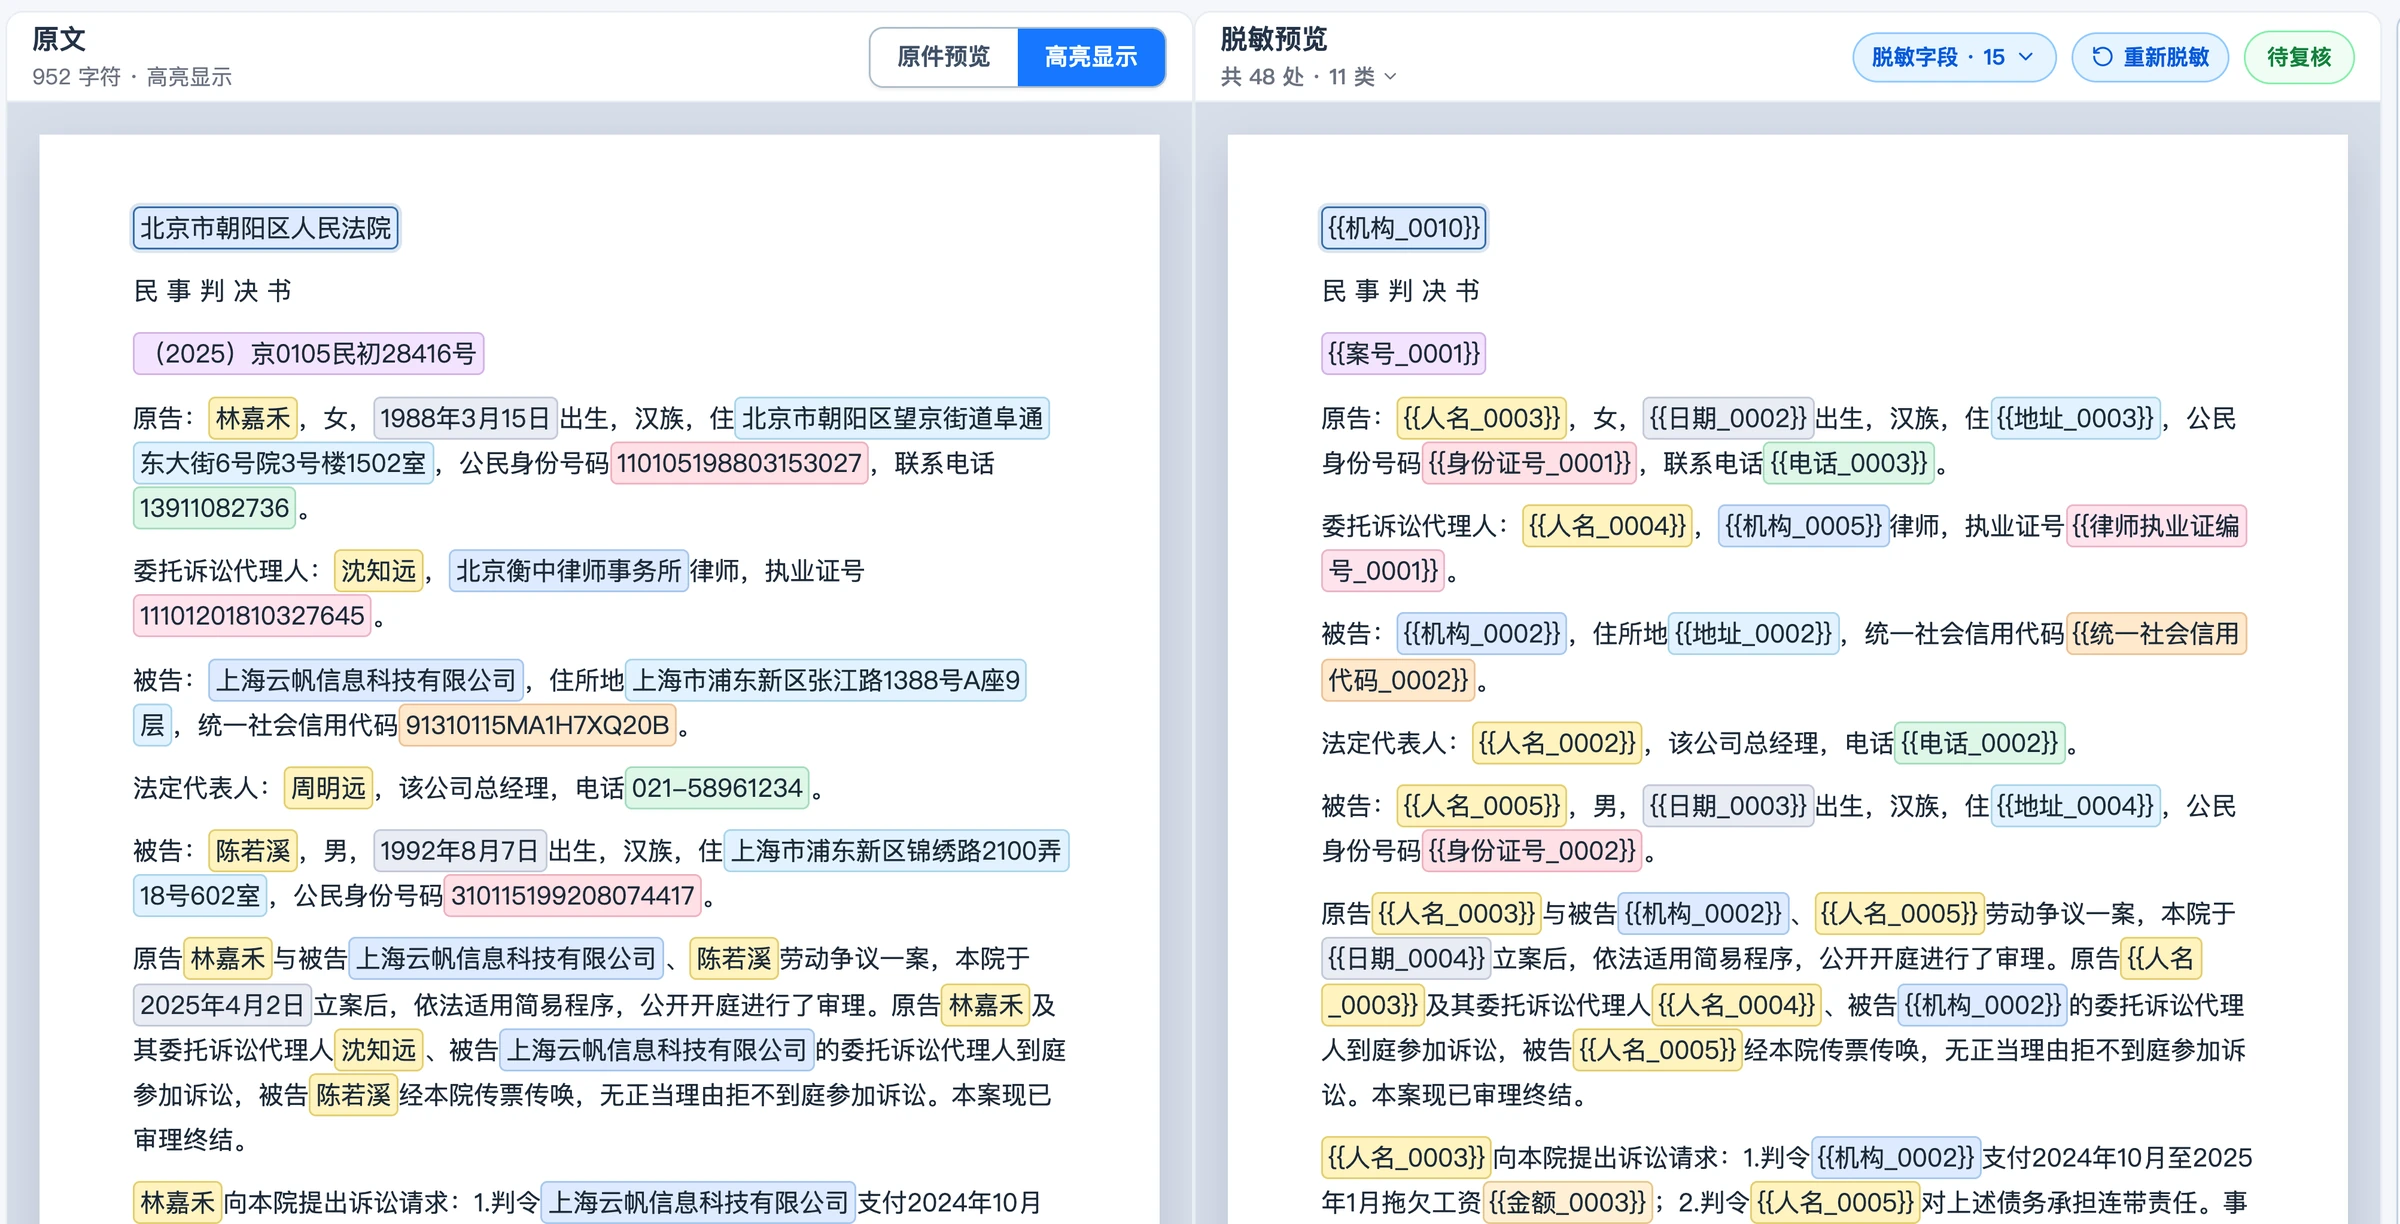
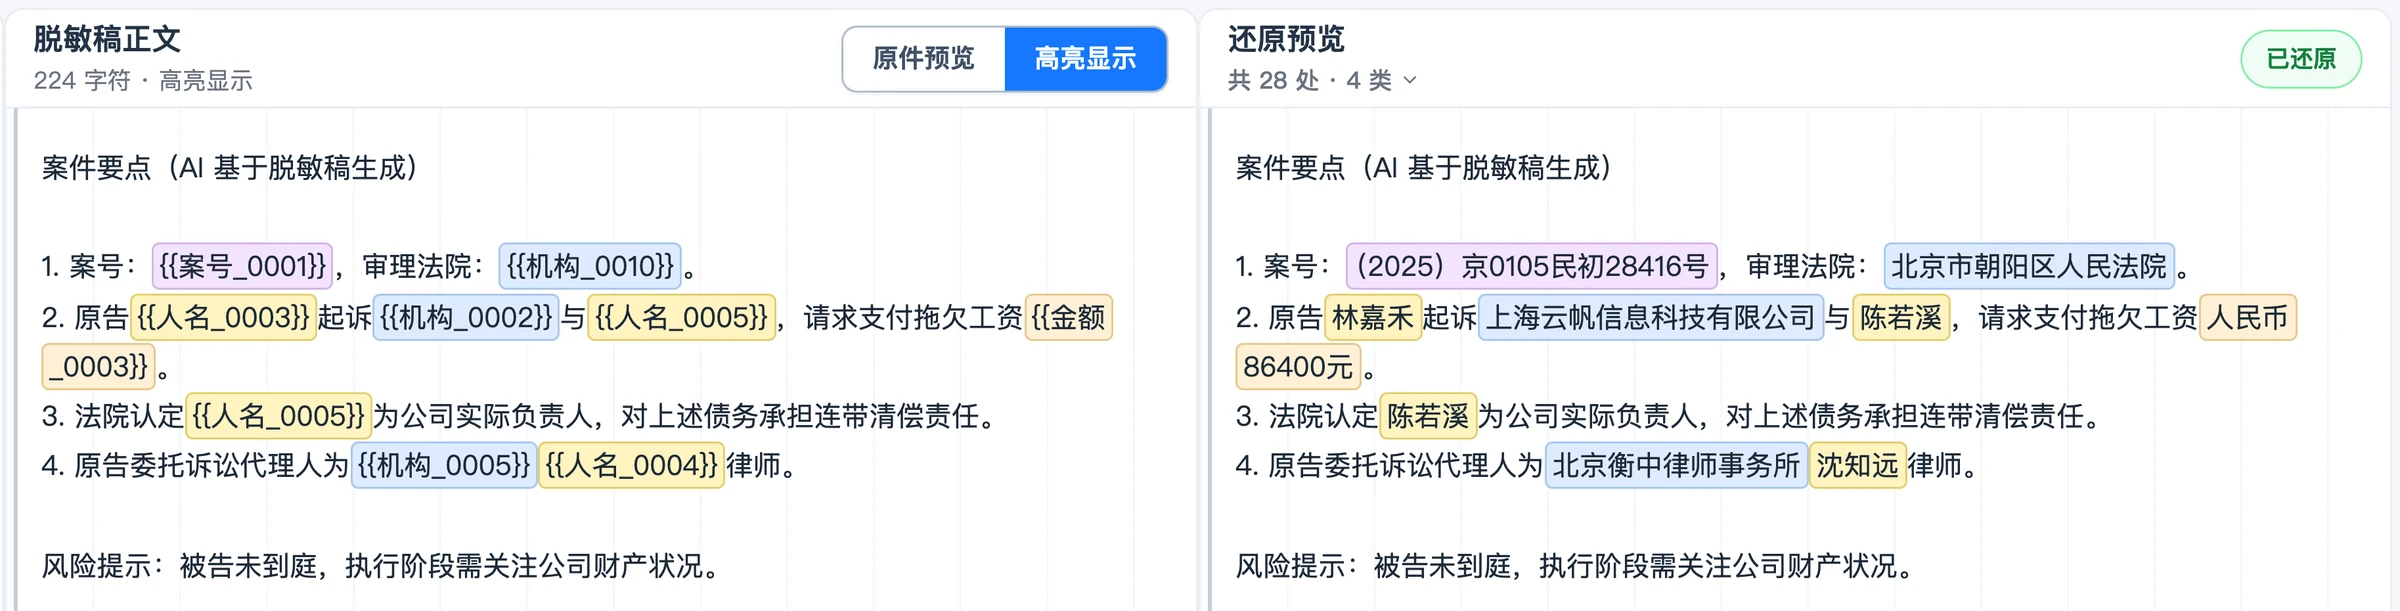
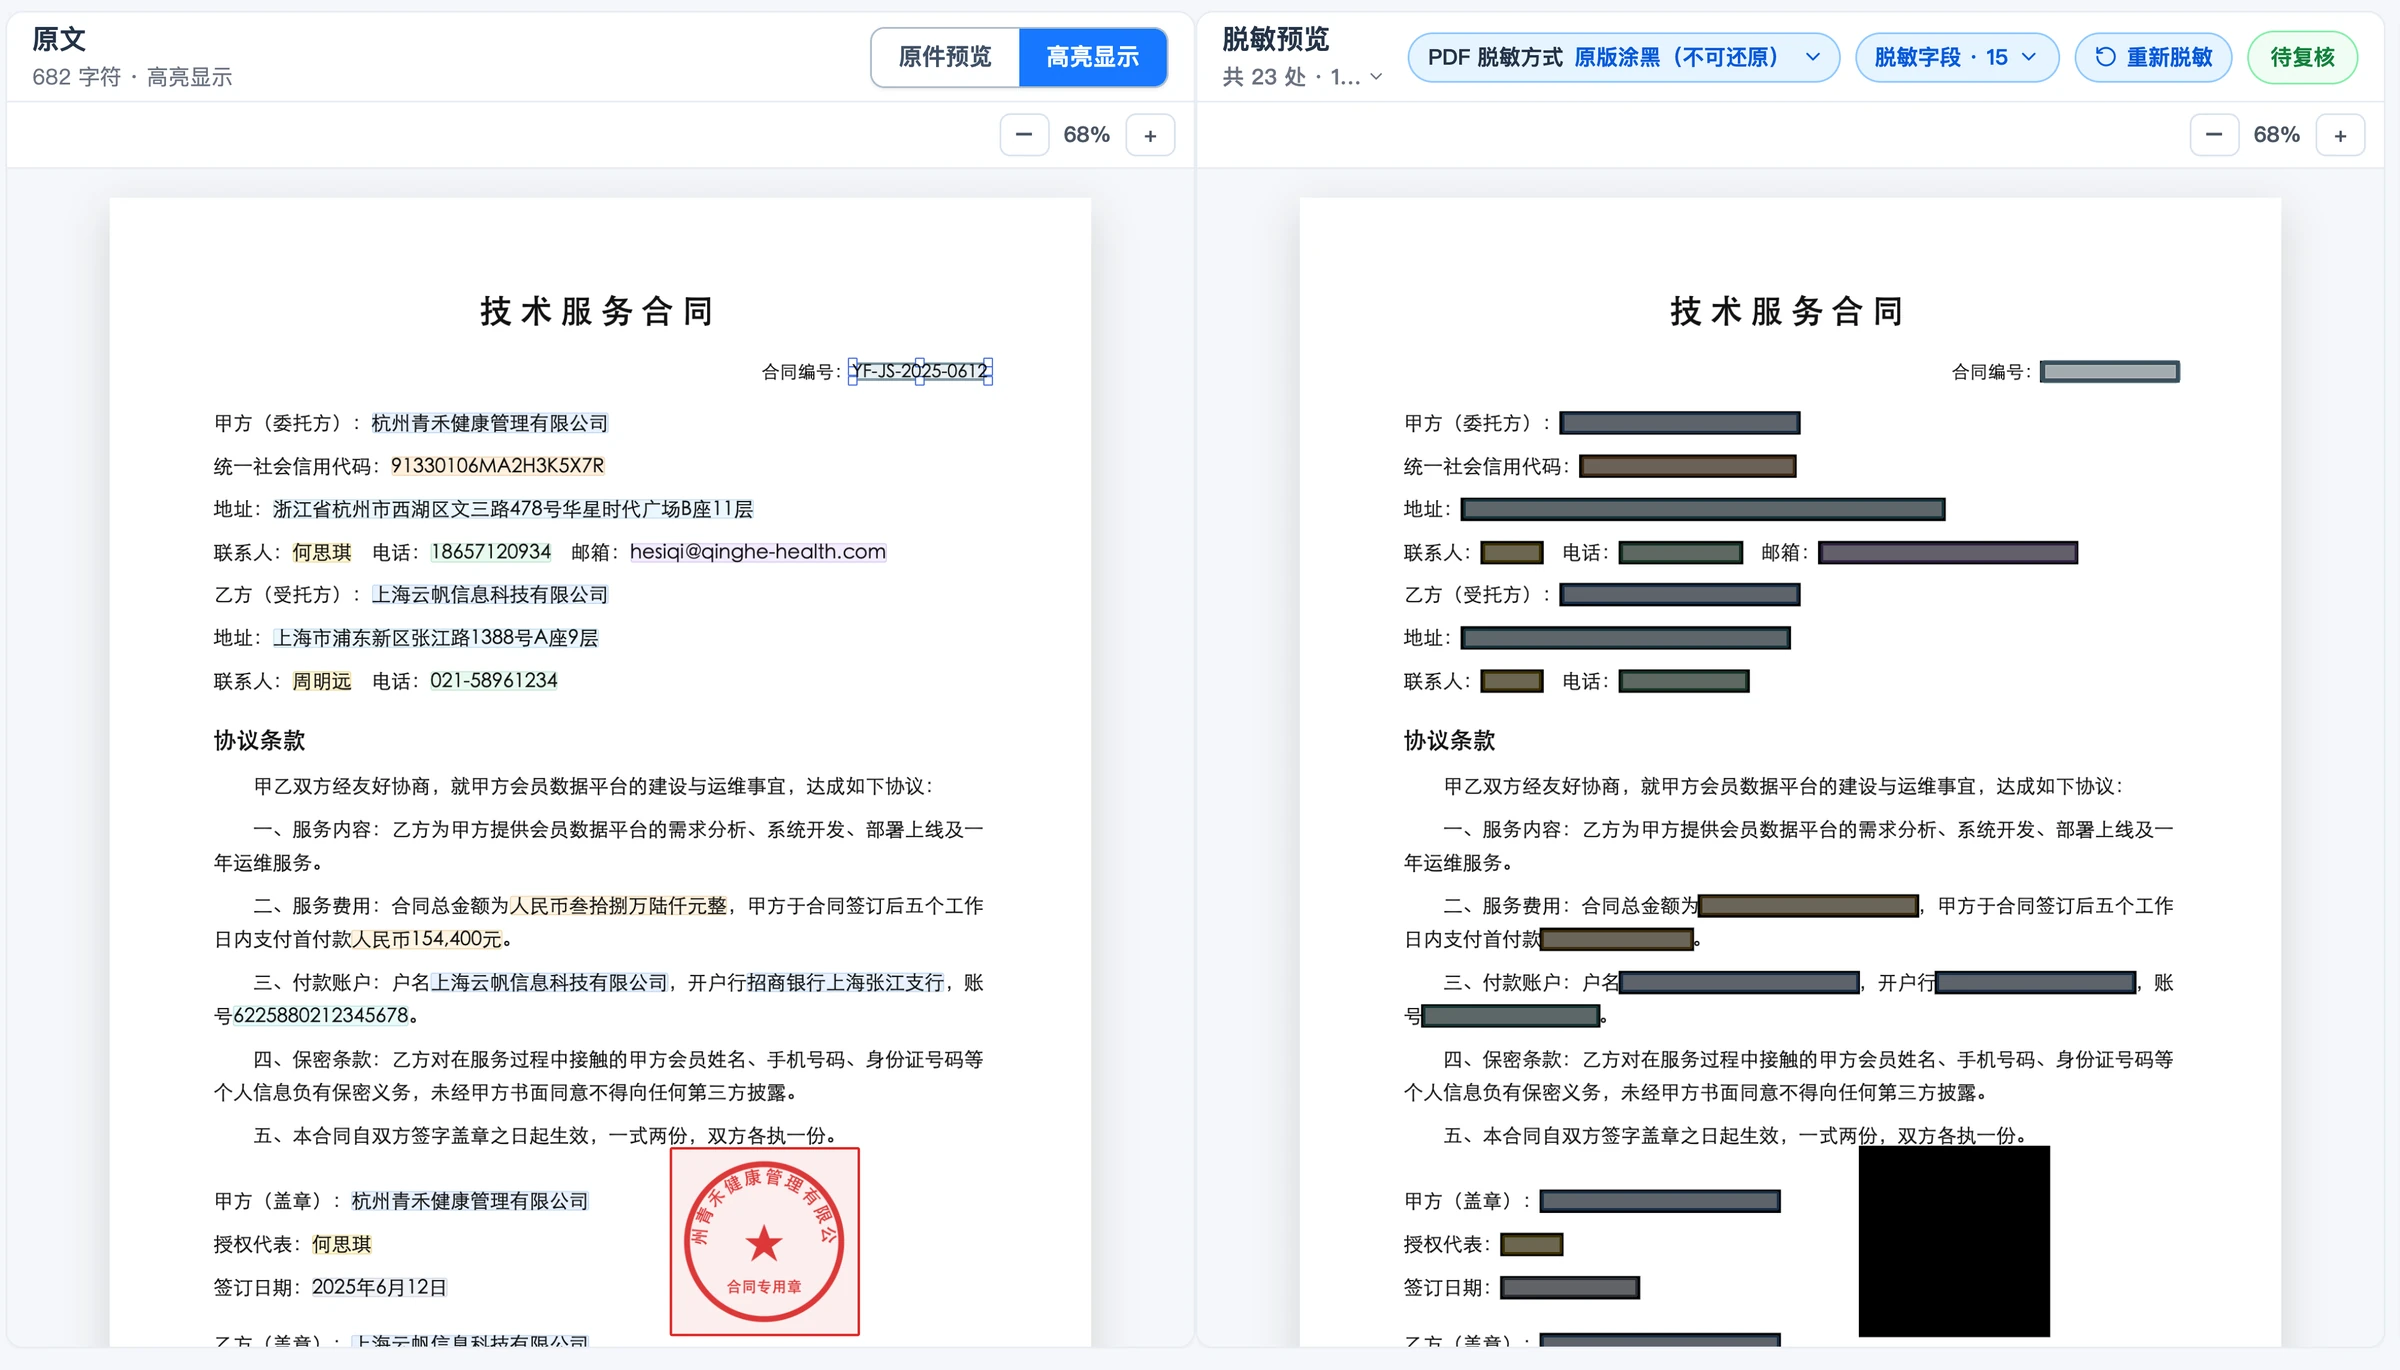
左侧为原始文件,右侧为供 AI 使用的脱敏版本;人名、机构、案号、证件号替换为带标识的占位符,原文排版完全保留。
- 03
AI 产出内容,一键还原原始信息
AI 基于脱敏文稿生成案件摘要,回传后依托对照表将占位符批量还原为真实内容;所有还原位置高亮标记,核验完成后导出文件。
- 04
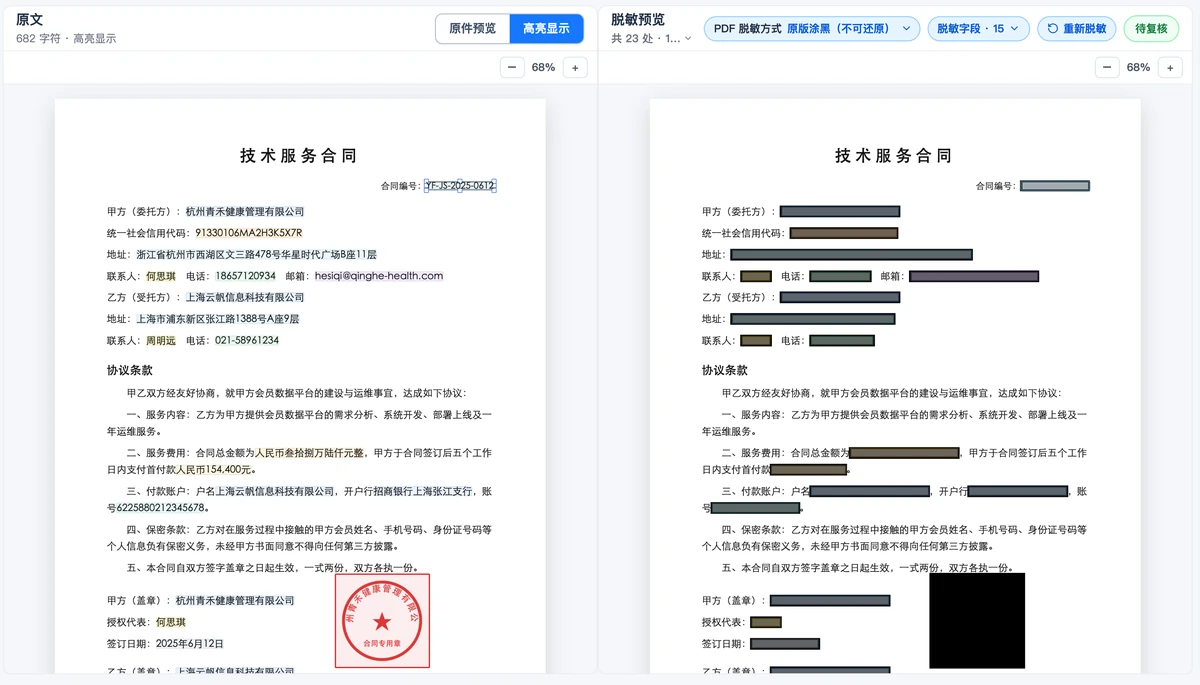
PDF 底层涂黑,页面布局不受改动
直接清除 PDF 底层敏感文字,而非简单叠加黑遮罩,页面版式维持不变;红色印章自动识别,签名、照片支持手动框选脱敏。
本地部署,数据自留
识别模型本地运行,仅脱敏文本发送至 AI,原件与对照表始终保存在本地。
桌面版
单人单机,macOS/Windows 绿色包,解压即用,无需依赖。
团队服务器
部署在机房或私有云;账号隔离、支持 SSO,管理员统一管理 AI 模型。
离线模式
识别、复核、导出、还原断网可用;可对接内网 AI 模型。
运行要求
- 系统
- 桌面:macOS、Windows;服务端:Linux
- 内存
- 建议 16GB 以上可用内存
- 显卡
- 无需独立显卡
青椒脱敏工作台适用场景
律所与法务
处理判决书、合同与法律意见材料时,自动识别案号、人名、机构名称、证件号等信息,并在复核后完成脱敏或还原。
金融与尽职调查
在数据室文件、尽调报告和交易材料中,对目标公司名称、账号、金额、交易条款等敏感内容进行识别与遮蔽。
人力资源
基于员工调查记录、访谈材料和内部报告,对员工姓名、联系方式及个人敏感信息进行受控处理,辅助生成摘要与制度答复。
研究与访谈
对访谈转写稿、调研记录和编码材料进行结构化处理,在保留研究语义的同时,对受访者身份与敏感信息进行匿名化处理。
与常见做法对比
| 手动脱敏 | 浏览器提示词脱敏插件 | 去标识化 API | 青椒脱敏工作台 | |
|---|---|---|---|---|
| 完整文件(Word、Excel、PDF 等) | 操作繁琐 | 粘贴的文字 | 需要开发集成 | 支持 |
| AI 回答后可还原 | 不能 | 仅当前会话 | 需自己实现 | 可以,按文档还原 |
| 逐字段复核 | 全靠手工 | 很少有 | 没有界面 | 支持 |
| 不经过厂商云端 | 是 | 通常是 | 部分可自部署 | 是 |
常见问题
需要显卡或者自建大模型吗?
不需要。识别在普通 CPU 上就能运行,实测内存峰值约 1.2 GB。你照常使用 DeepSeek、GPT 这类顶级模型,发给它的只有脱敏后的文字。
文件会离开我的电脑吗?
不会。解析、识别、复核和还原都在你的电脑或自己的服务器上完成。只有你主动交给 AI 的脱敏稿才会发出去。
能配合 DeepSeek、通义千问、豆包这类国产大模型使用吗?
可以。内置问答支持任何兼容 OpenAI 接口的模型服务,管理员配置后即可使用;你也可以导出脱敏稿,上传到任意 AI 工具。
能针对我们这类文件做适配吗?
可以。开关字段类型、添加自定义规则(比如案件编号或员工工号)、维护永不脱敏的词表;需要时,还可以在你们的环境里微调识别模型。